


NVIDIA, hız ve bellek verimliliğine odaklanan yeni açık küçük dil modeli Nemotron 3.5 Bolt E4B 4GB’yi duyurdu. Gemma 4 E4B üzerine NVIDIA’nın Nemotron eğitim sonrası (post-training) yöntemleri uygulanarak geliştirilen model, doğal konuşma yeteneklerini çok turlu araç kullanımıyla birleştiriyor.
Yeni model; sesli ve cihaz asistanları, etkileşimli karakterler, robotik ve nesnelerin interneti (IoT) arayüzleri için tasarlandı. NVIDIA GeForce RTX, Jetson, RTX Spark ve DGX Spark platformlarında çalıştırılabilen Bolt E4B, hedeflenen iş yüklerinde yaklaşık 4 GB gibi düşük bir bellek kullanımıyla yerel yapay zekâ deneyimleri sunmayı ve aynı süreçteki uygulamalar ile diğer modeller için de bellekte yer bırakmayı amaçlıyor.
NVIDIA’nın yayımladığı karşılaştırmalı test sonuçları, Nemotron 3.5 Bolt E4B’nin şirketin önceki modeli Nemotron 3 Nano 4B’ye göre değerlendirilen testlerde ortalama yaklaşık yüzde 40 daha yüksek puan aldığını gösteriyor.
Yeni model, aynı testlerde değerlendirilen diğer rakip modellere kıyasla da ortalama yaklaşık yüzde 10 daha yüksek puana ulaşıyor.
NVIDIA ayrıca akıl yürütmenin etkin olduğu karşılaştırmalarda modelin rakiplerinden yaklaşık yüzde 80’e kadar daha az çıktı token’ı ürettiğini belirtiyor. Gereksiz token üretiminin azaltılması, hesaplama maliyetlerini düşürürken yanıt sürelerinin kısalmasına da katkıda bulunabiliyor.
Modelin performansı konuşma ve karakter tutarlılığı, çok turlu araç kullanımı, talimatlara uyum, uzun bağlamı işleme ve sağlanan bilgiler doğrultusunda doğru eylemler gerçekleştirme gibi beş temel yetenek alanında değerlendirildi.
Nemotron 3.5 Bolt E4B, 64 bin token bağlam penceresiyle konuşma geçmişini, talimatları, araç tanımlarını, alınan bilgileri ve uygulama durumunu birlikte işleyebiliyor.
Modelin öne çıkan özellikleri arasında çok turlu araç çağırma, doğal konuşmalara uygun kısa yanıtları teşvik eden ve açılıp kapatılabilen konuşma modu ile yapılandırılabilir akıl yürütme bulunuyor.
Karmaşık taleplerde akıl yürütme etkinleştirilebilirken daha hızlı yanıt gerektiren uygulamalarda bu özellik devre dışı bırakılabiliyor. Model ayrıca 35 dili destekliyor ve 140’tan fazla dilde ön eğitim almış bir temel model üzerine inşa ediliyor.
NVIDIA, modelin farklı donanımlardaki bellek tüketimi ve yanıt hızlarına ilişkin ölçümlerini de yayımladı.
Önbelleğe alınmış bağlamın kullanılmadığı, 3 bin yeni girdi token’ı ve 50 çıktı token’ı içeren bir testte Nemotron 3.5 Bolt E4B, RTX 5070 üzerinde 3,5 GB ekran kartı belleği kullanırken saniyede 133,4 token üretim hızına ulaştı. Aynı testte ilk token’a ulaşma süresi 548 milisaniye olarak ölçüldü.
Jetson Orin Nano 8GB üzerinde yapılan eşdeğer iş yükü testinde ise 4,2 GB bellek kullanımı ve saniyede 15,5 token üretim hızı kaydedildi.
Bu ölçümler Q4_K_M kuantizasyonuyla, batch boyutu (batch size) 1 olacak şekilde, CUDA üzerinde llama.cpp ve AIPerf kullanılarak gerçekleştirildi. NVIDIA, sonuçların donanıma, çıkarım yazılımına ve yapılandırmaya göre değişebileceğini belirtiyor.
NVIDIA, müşterilerinin dil modellerini bilgisayar ve mobil cihaz kontrolünden müşteri hizmetlerine ve araç içi deneyimlere kadar çeşitli alanlarda kullanmaya giderek daha fazla ilgi gösterdiğini belirtiyor. Bolt E4B de bu tür deneyimleri hedefliyor.
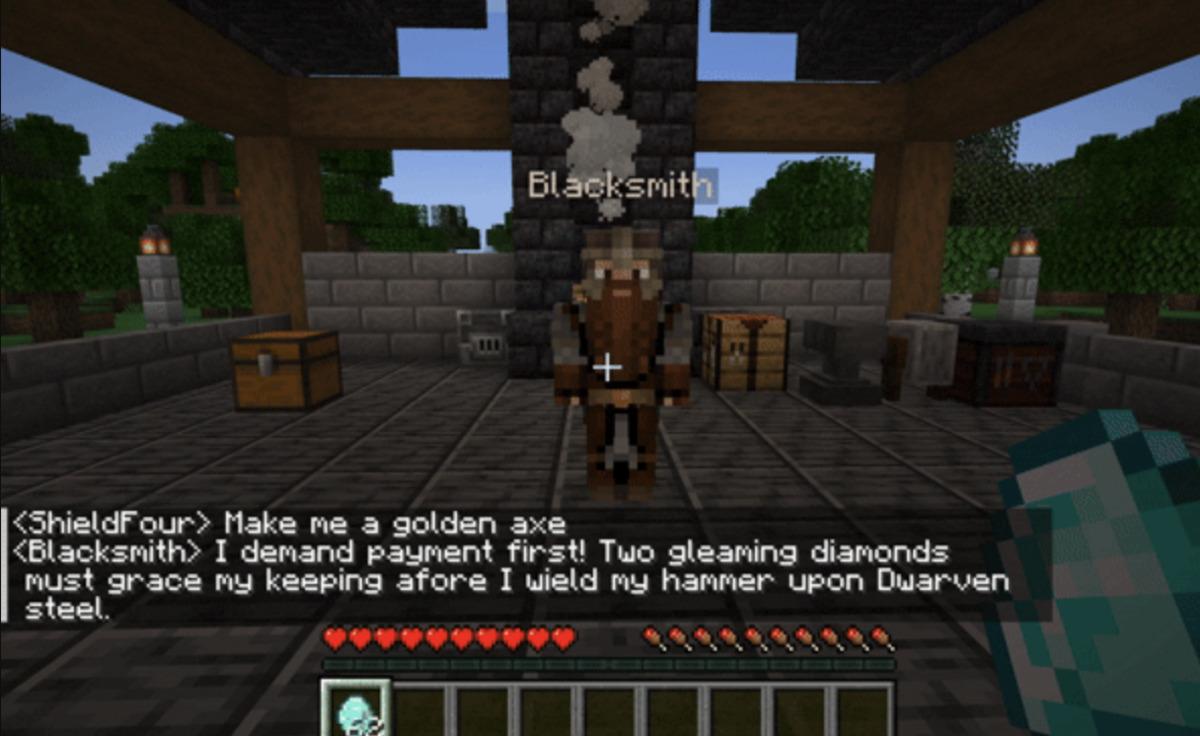
Model, oyunlardaki oyuncu olmayan karakterlerin (NPC) yalnızca konuşmasını değil, araçları kullanarak işlem gerçekleştirmesini de destekliyor.
NVIDIA’nın paylaştığı örneklerden birinde sanal bir demirci karakteri, bir ürün için yapılan ödemenin doğruluğunu kontrol ettikten sonra araçları otonom olarak çağırarak üretim tariflerini sorguluyor, gerekli malzemeleri topluyor, ürünü hazırlıyor ve kullanıcıya aktarıyor.
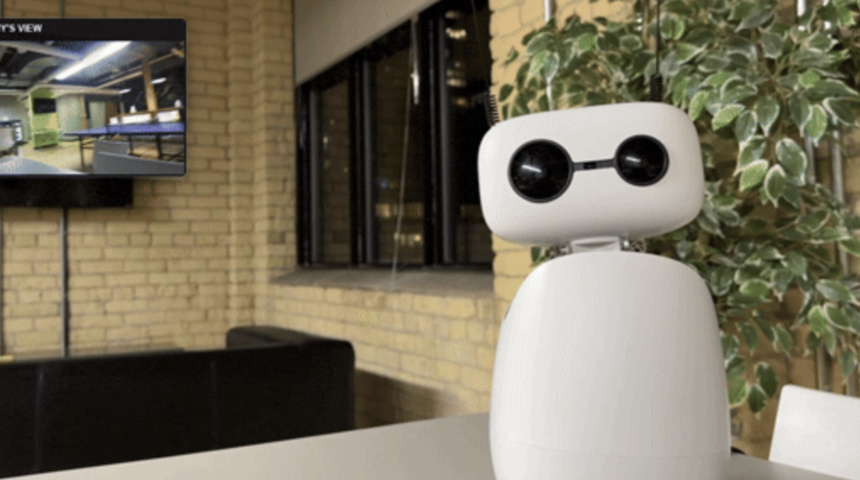
Robotik uygulamalara yönelik bir başka örnekte ise Reachy Mini robotu Jetson Orin Nano 8GB üzerinde çalışıyor. Cosmos 3 Edge, çevreye ilişkin gerçek zamanlı görsel bilgileri Bolt E4B’ye sağlıyor; Bolt E4B de robotun animasyon kütüphanelerindeki betikleri çağırıyor ve sözlü yanıtlarını üretiyor.
NVIDIA, yeni modeli Hugging Face, Ollama, LM Studio, Unsloth, Canonical, Jetson AI Lab ve NVIDIA In-Game Inferencing SDK üzerinden erişime açtı.
Şirket ayrıca model kartını, dağıtım örneklerini, eğitim yöntemlerini ve uygulama yapılandırma rehberlerini de paylaşıyor.
Nemotron 3.5 Bolt E4B, NVIDIA’nın düşük bellek tüketimi, yanıt hızı ve çok turlu araç kullanma yeteneklerini bir araya getirerek yapay zekâ asistanlarını doğrudan cihazlar üzerinde çalıştırmaya yönelik yeni modeli olarak öne çıkıyor.
 markasıdır.





 Haber Gönder
Okuyucu Yorumları 0 yorum